코딩 에이전트 작업 환경 구성의 두 번째 글이다. 1편에서는 토큰을 더 쓰더라도 설계와 검증을 건너뛰지 않게 하는 도구들을 다뤘다. 이번에는 반대로, 성능을 최대한 유지하면서 불필요한 토큰 사용을 줄이는 도구들이다.
내가 쓰는 방식은 크게 세 가지다. 말을 줄이는 것(caveman), 만드는 코드를 줄이는 것(ponytail), 읽는 코드를 줄이는 것(Serena). 여기에 필요하면 서브에이전트를 써서 메인 세션의 컨텍스트가 쓸데없이 커지는 것도 막는다.
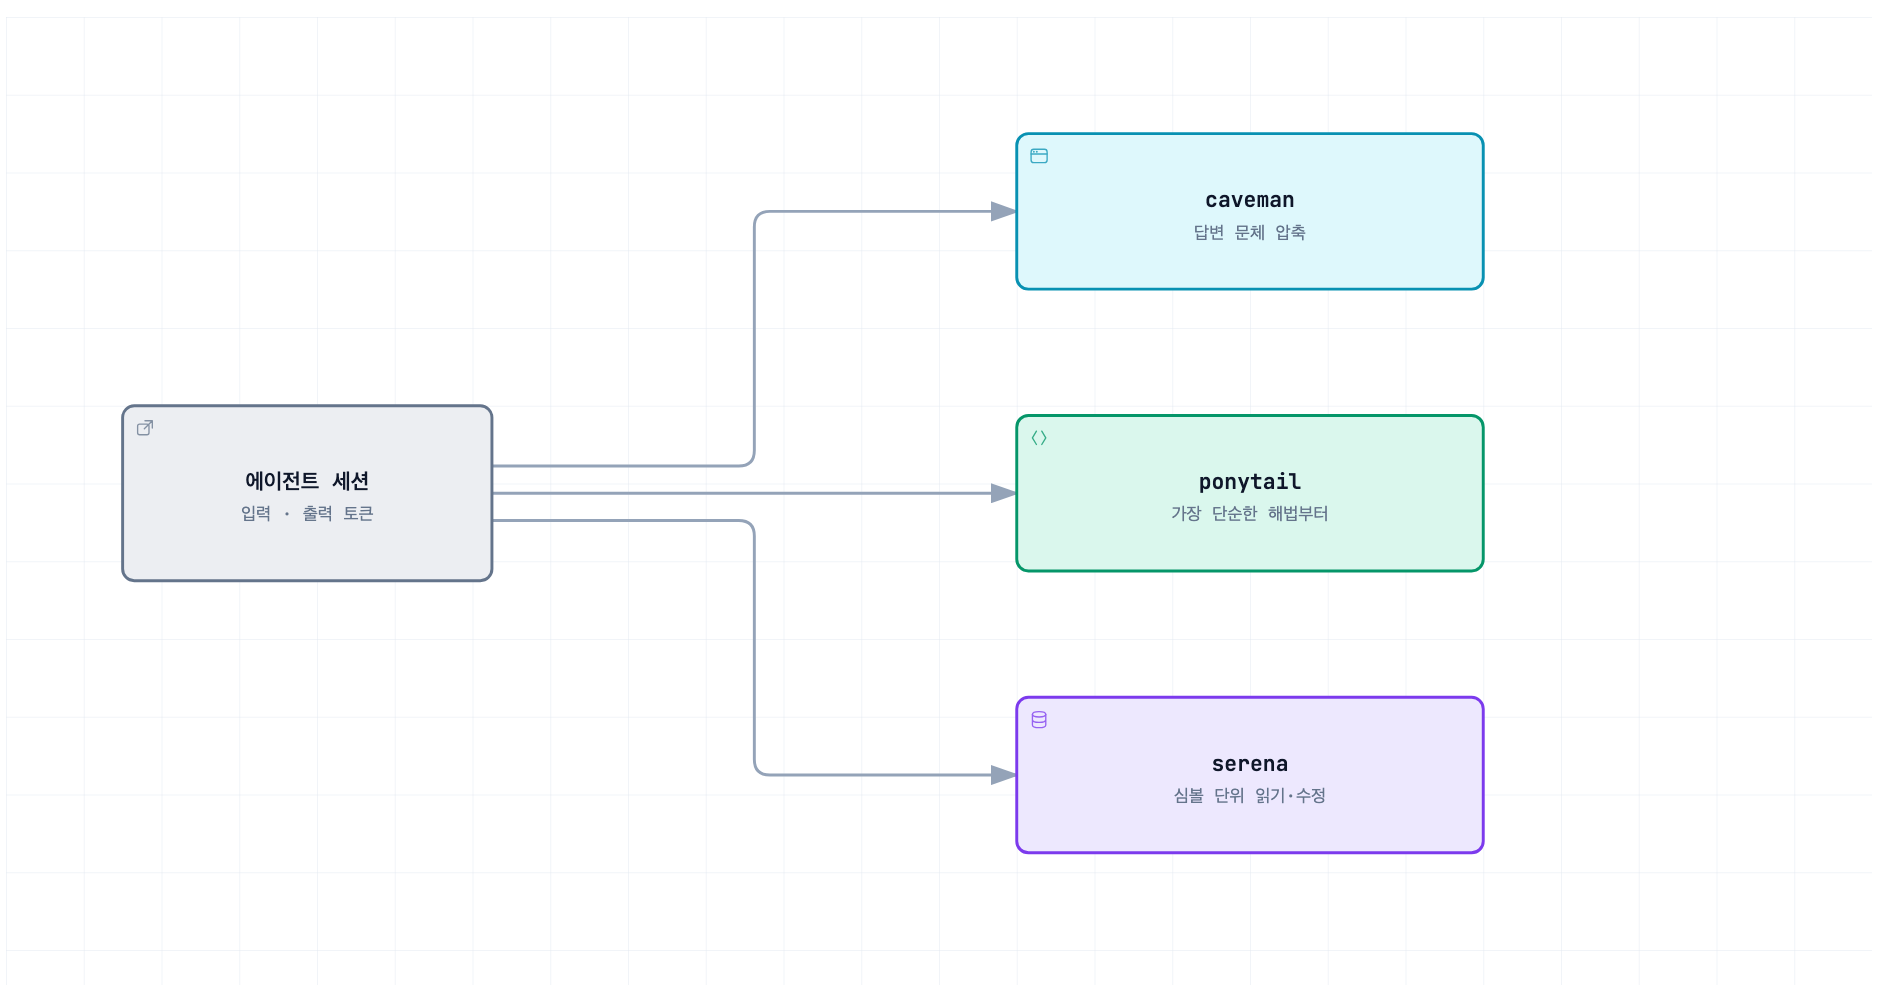 에이전트 세션의 입력·출력 토큰을 caveman, ponytail, serena가 각각 줄이는 구성
1. caveman: 말을 줄이기
caveman은 에이전트의 답변을 짧고 압축적으로 만드는 플러그인이다. Claude Code에서는 세션 시작 때 항상 켜지게 해 두었고, 기본 수준은 full이다.
단순히 문장을 짧게 자르는 게 아니라, 의미는 유지하면서 불필요한 표현만 줄인다. 약어를 억지로 만들거나 not, only처럼 의미를 바꾸는 단어를 지우지 않는다. 보안 경고나 되돌릴 수 없는 작업처럼 정확성이 중요한 상황에서는 일반 문체로 돌아간다. 문서, PR, 이슈, 커밋 메시지처럼 사람이 다시 읽을 글도 일반 문체를 유지한다.
함께 딸린 caveman-compress로는 CLAUDE.md처럼 매 세션 읽는 파일도 압축할 수 있고, caveman-stats로 실제 토큰 사용량과 추정 절감량을 볼 수 있다.
써 보면서 더 중요하다고 느낀 것은 서브에이전트를 활용한 컨텍스트 관리다. 코드베이스 탐색이나 조사를 서브에이전트에 맡기면, 탐색하며 읽은 내용을 전부 메인 세션에 쌓지 않고 필요한 결과만 요약해서 받을 수 있다.
다만 서브에이전트도 별도의 컨텍스트와 추론 토큰을 쓰기 때문에 전체 토큰 사용량이 항상 줄지는 않는다. 그래서 대략 이렇게 나눈다.
| 작업 | 처리 방식 |
|---|---|
| 독립적인 탐색·조사 | 서브에이전트 |
| 같은 컨텍스트를 계속 쓰는 작업 | 메인 세션 |
| 병렬 처리가 가능한 독립 작업 | 서브에이전트 병렬화 |
| 서로 강하게 연결된 연속 작업 | 한 세션에서 처리 |
서브에이전트의 가장 큰 장점은 토큰 절감보다는, 메인 컨텍스트를 불필요한 탐색 정보로부터 격리하는 데 있다고 본다.
2. ponytail: 만드는 코드를 줄이기
ponytail은 코드를 쓰기 전에 "정말 새 코드를 써야 하는가"부터 검토하게 하는 플러그인이다. 콘셉트는 게으른 시니어 개발자다. 여기서 게으름은 대충 만든다는 뜻이 아니라, 불필요한 코드를 최대한 만들지 않는다는 뜻에 가깝다.
해결 방법은 대략 이 순서로 검토한다.
- 이 기능이 정말 필요한가
- 기존 코드에 같은 기능이 이미 있는가
- 표준 라이브러리나 플랫폼 기본 기능으로 해결되는가
- 이미 설치된 의존성을 쓸 수 있는가
- 그제야 최소한의 코드를 쓴다
예를 들어 날짜 입력을 만들 때 바로 라이브러리를 추가하기보다 <input type="date">로 되는지 먼저 본다. JavaScript를 쓰기 전에 CSS만으로 되는지 보고, 애플리케이션 코드로 검증하기 전에 DB 제약 조건으로 처리할 수 있는지도 본다.
버그 수정에서도 여러 호출부에 같은 방어 코드를 넣기보다, 모든 호출이 지나가는 공용 지점에서 근본 원인을 고치는 쪽을 우선한다. 다만 보안, 데이터 유실 방지, 입력 검증, 접근성, 사용자가 명시한 요구 사항은 단순화를 이유로 빼지 않는다.
역할을 나누면 caveman은 "어떻게 말할 것인가"를, ponytail은 "무엇을 만들 것인가"를 줄이는 도구다.
3. ponytail을 고른 이유
ponytail과 비슷한 역할을 하는 karpathy-skills도 함께 검토했다. 두 도구 모두 코드 작성 방식을 제어해서, 같이 쓰면 일부 규칙이 충돌했다.
그래서 ponytail, karpathy-skills, 아무것도 적용하지 않은 기본 상태를 각각 격리해 같은 개발 요청으로 비교했다. 날짜 입력, 캐싱, 리팩터링, 재시도 처리, 페이지네이션 같은 일반적인 작업으로 비교해 보니, 내 환경에서는 ponytail이 코드 품질과 동작 안정성 면에서 더 잘 맞았다. 그래서 지금은 ponytail만 켜고 karpathy-skills는 꺼 두었다.
이 결과는 절대적인 우열이라기보다 내가 쓰는 코드베이스와 작업 방식에서의 결과다.
4. Serena: 읽는 코드를 줄이기
Serena는 에이전트가 코드를 파일 전체가 아니라 함수나 클래스 같은 심볼 단위로 탐색하고 고치게 돕는 도구다. MCP 서버로 연결해 쓰고 있고, 큰 코드베이스에서 파일 전체를 쓸데없이 읽는 일을 줄이는 데 쓴다.
Serena는 언어 서버가 주는 코드 구조 정보로 다음 작업을 한다.
- 특정 함수나 클래스 찾기
- 정의 위치 확인
- 심볼의 참조 위치 추적
- 필요한 함수나 클래스 내부만 조회
- 심볼 단위 수정과 이름 변경
예를 들어 UserService가 어디서 쓰이는지 보고 싶으면, 모든 파일을 문자열 검색할 필요 없이 실제 참조 관계를 따라 필요한 위치만 확인하면 된다.
이 방식의 장점은 에이전트가 코드베이스를 텍스트 파일 묶음이 아니라 서로 연결된 프로그램 구조로 볼 수 있다는 점이다. 파일이 많은 프로젝트일수록 관련 없는 코드를 컨텍스트에 넣지 않고 필요한 부분만 읽을 수 있어 효과가 크다.
다만 모든 작업에 Serena를 쓰지는 않는다.
- 심볼 조회, 참조 추적, 여러 파일에 걸친 분석·리팩터링 → Serena
- 단순 텍스트 검색, 설정 파일, SQL, 셸 작업, 작은 수정 → 기본 도구
큰 코드 구조를 따라가야 할 때만 Serena를 쓰고, 단순 작업에는 기본 도구를 쓰는 편이 오히려 효율적이다.
5. 한계
이 도구들도 공짜로 토큰을 줄여 주지는 않는다. caveman이나 ponytail 같은 규칙은 세션 시작 때 프롬프트에 들어가니 그 자체로 고정 입력 토큰을 쓴다. Serena도 언어 서버를 준비하고 도구를 호출하는 비용이 있고, 서브에이전트도 메인 컨텍스트는 줄여 주지만 별도의 컨텍스트와 추론 토큰을 쓴다.
그래서 중요한 것은 모든 작업에 무조건 적용하는 게 아니라, 각 도구가 실제로 이득을 주는 범위에서만 쓰는 것이다.
6. 마무리
지금 쓰는 토큰 절감 방식을 정리하면 이렇다.
| 도구 | 줄이는 것 |
|---|---|
| caveman | 에이전트가 말하는 양 |
| ponytail | 에이전트가 만드는 코드의 양 |
| Serena | 에이전트가 읽어야 하는 코드의 양 |
| 서브에이전트 | 필요할 때 탐색 과정의 컨텍스트를 메인 세션에서 분리 |
답변을 무조건 짧게 만드는 게 목적은 아니다. 에이전트가 말하고, 만들고, 읽는 범위 자체를 줄여 같은 작업을 더 작은 컨텍스트로 처리하게 만드는 것이 이 구성의 핵심이다.
에이전트 자체의 작업 성능을 끌어올리는 데에는 한계가 있고, 결국 작업 성능을 가장 크게 바꾸는 것은 프론티어 모델의 발전이라고 생각한다. 그래서 요즘은 제한된 한도 안에서 얼마나 많은 일을 효율적으로 해낼 수 있는지가 더 중요하다고 느낀다.
다음 편에서는 토큰이 아니라 사람 쪽의 효율을 다룬다. 에이전트의 결과를 읽고 바로 다음 행동으로 옮길 수 있게 만드는 설정들이다.